> For the complete documentation index, see [llms.txt](https://growingio.gitbook.io/v3/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://growingio.gitbook.io/v3/product-manual/data-center/data-management/auto/web-duan-shu-ju-ding-yi/web-quan-xuan.md).

# Web圈选

## Web圈选操作 <a href="#id-1-kai-shi-quan-xuan" id="id-1-kai-shi-quan-xuan"></a>

在顶部导航栏选择“**数据中心 > 无埋点事件定义（圈选） > 您的Web应用”**，进入Web圈选模式。

{% hint style="success" %}
Web圈选模式分为浏览和圈选两个模式

浏览模式：在浏览模式下选择您要圈选页面或元素所在页面。

圈选模式：在选定页面后进入圈选模式，定义页面中的元素。
{% endhint %}

{% tabs %}
{% tab title="定义页面" %}
1、在浏览模式下进入要定义的页面，单击圈选模式下的**定义页面**按钮，进入**定义页面**界&#x9762;**。**

![](https://3124430735-files.gitbook.io/~/files/v0/b/gitbook-legacy-files/o/assets%2F-M2rhnIRdtpnYwQL2kvm%2F-M8hVhbqi7wjg65tnl38%2F-M8hejtyHn_ZFfv50yBC%2Fimage.png?alt=media\&token=adb51363-5313-47fc-b3b5-47aa371fc9e6)

左侧选择区：显示与当前页面URL相同的页面（以【当前页】为标识），或包含当前页面的页面。如果页面已经被定义过，可以直接使用。

右侧编辑区：按照页面结构，我们把一个完成的URL拆解成了域名、路径和查询条件（如有则显示）。

路径：定义页面时会自带路径，打开路径表示定义的是当前路径页面，关闭路径后表示定义的是符合域名条件的所有页面。

查询：当页面有查询条件时会自带查询条件，打开查询表示定义的是符合查询条件的所有页面，关闭查询不对查询条件进行定义。

{% hint style="info" %}
**使用查询条件说明**

打开查询条件的页面数据不支持回溯，将从页面定义的时候开始统计数据。
{% endhint %}

{% hint style="success" %}
**定义一组页面**

支持在路径中使用 \* 作为通配符，达到定义一组类似页面的功能。

例如GrowingIO 博客文章内容的地址都是这样的

* <https://blog.growingio.com/posts/100>
* <https://blog.growingio.com/posts/101>
* <https://blog.growingio.com/posts/102>......

那么我们在路径中输入 /posts/\* 就会圈选出所有的博客单篇文章的页面。
{% endhint %}

2、配置参数定义参数后单击**保存**，完成对此页面的定义。

> 对于已被定义过的页面您在修改参数后进行更新或另存为操作。
> {% endtab %}

{% tab title="定义元素" %}
1、 在浏览模式下进入要定义元素所在的页面，单击**圈选**，进入元素圈选模&#x5F0F;**。**

2、 单击待定义的元素，弹出定义元素界面。

{% hint style="info" %}
当需要定义需要鼠标悬浮等交互行为才能显示的元素时，您可以按住shift键，待元素出现后进行圈选定义。
{% endhint %}

![](https://3124430735-files.gitbook.io/~/files/v0/b/gitbook-legacy-files/o/assets%2F-M2rhnIRdtpnYwQL2kvm%2F-MCHOW2OhaVQGXljdhI3%2F-MCHOsY9U5qQaSicHX6L%2Fimage.png?alt=media\&token=e05a6e2f-bcc9-4c5d-b88c-d502875027f3)

| 参数 | 说明 |
| -- | -- |

| 所属页面 | 确认元素所在的页面是什么。如果这个元素出现在多个页面同样的位置，想要统计所有的数据，可以通过”定义页面“，先定义元素所在的页面组，在在这里选择该页面组。 |
| ---- | ---------------------------------------------------------------------------- |

| 限定条件 | <p>设置元素当前的文本、顺序、转跳链接等限定条件，确定元素统计的规则。</p><p>内容：</p><p>顺序位：</p><p>转跳链接：</p> |
| ---- | ------------------------------------------------------------------------- |

| 动态展示区 | 通过动态展示区确认是不是自己想要定义的元素和规则。 |
| ----- | ------------------------- |

> 对于已被定义过的元素您在修改参数后进行另存为操作。

{% hint style="info" %}
**高亮显示说明**

圈选导航栏上显示默认开启&#x4E86;**「高亮已定义元素」**，您可以看到哪些元素被定义过。

高亮模式下，粉色实线代表已经被圈选的元素，粉色虚线代表已经被圈选的同类元素，点击元素后可以看到最近一次被定义的规则。

单击**显示**，可选择关闭高亮显示。
{% endhint %}
{% endtab %}

{% tab title="将查询条件设置为页面级变量" %}

> SDK版本支持：>=2.x

以<https://www.growingio.com/projects/1/homepage/overview?platform=ios&channel=banner为例，“?”后面的部分我们通常叫做查询条件（Query），在这个> URL 中标记了这个页面是在哪个平台（platform）打开的，以及通过哪个渠道（channel）访问的等重要信息，不同的公司有不同的应用，这种应用非常常见，那么，我们如何把这些重要的信息利用起来呢？

现在不需要埋点和开发，可以直接将这些查询条件设置成页面级变量，即维度；不仅如此，相比与埋点信息的延时发送，GrowingIO 将页面与查询条件中的信息同时发送、采集和计算，没时差，再也不会有那么多的空值了。

#### 操作步骤

1、 在圈选模式下选择带有查询条件的页面，单击页面上方的**定义页面级变量。**

2、 选择需要定义的查询条件，为查询条件（标识符）命名后单击确定。

![](https://3124430735-files.gitbook.io/~/files/v0/b/gitbook-legacy-files/o/assets%2F-M2rhnIRdtpnYwQL2kvm%2F-MCHOW2OhaVQGXljdhI3%2F-MCHP1aM2LPDXGnI2n0V%2Fimage.png?alt=media\&token=00cf605c-27e8-4a64-a9c1-b90cbb1015a8)

{% hint style="info" %}
页面级变量说明

全局生效，一旦设置，全站采集，对域名下的所有加载了SDK的页面生效。

埋点优先，埋点页面的数据不受任何影响，只在没有埋点或延时导致埋点数据没有发出来时，会取”标识符“相同的查询条件对应的值。
{% endhint %}

### **设置查询条件为页面级变量的案例详解** <a href="#id-2-an-li-xiang-jie" id="id-2-an-li-xiang-jie"></a>

如果你之前进行了埋点，那么这个功能上线后会发生什么变化呢？

电商客户 S 为了分析商品的售卖情况，在详情页进行了埋点，将每个商品的编号、商品名称等设置成了页面级变量，已经实施后上线了，其中商品编号标识符为 id，是从内容中取值的。接下来，用户用这个页面级变量来拆分商品详情页，进行分析。

假设商品详情页的 URL 是这样的 [www.s.com/pro?id=342817\\\&city=bj](http://www.s.com/pro?id=342817\\\&city=bj) ，我们可以看到查询条件中的 id 就是这个商品的商品编号， **当这个功能上线后，由于「商品编号标识符： id」与「查询条件中的：id 」是一样的，我们会从打点设置的规则和 URL 中的查询条件中同时取 id 的值，**&#x6709;如下几种情况：

> 表格第四列「埋点取的值」 - 客户打点时的规则是从「内容」中取值；
>
> 表格第五列「URL 取的值」 - 这个功能上线后我们从 URL 中取到对应的 key 的值。

{% hint style="success" %}
对于下面表格内容的总结

1.只要埋点取到了值，就取埋点的值。（表格中的第 1 个和第 2 个情况）

2.如果一个页面上，没有埋点的值，不管是因为这个页面没有埋点，还是因为发送时间导致没有发送出来，会取查询条件中取到的值。（表格中的第 3 个和第 4 个情况）
{% endhint %}

| # | ​ | 变化 | 埋点取的值 | URL 取的值 | 之前 | 之后 |
| - | - | -- | ----- | ------- | -- | -- |

| 第 1 个情况 | <p><strong>商品详情页1</strong></p><p>商品页内容中的值 342817</p><p>[www.s.com/pro?id=342817\&city=bj](http://www.s.com/pro?id=342817\&city=bj)</p> | 无变化 | **342817** | 342817 | 342817 | **342817** |
| ------- | -------------------------------------------------------------------------------------------------------------------------------------- | --- | ---------- | ------ | ------ | ---------- |

| 第 2 个情况 | <p><strong>商品详情页1</strong></p><p>商品页内容中的值 ac487</p><p>[www.s.com/pro?id=342816\&city=bj](http://www.s.com/pro?id=342816\&city=bj)</p> | 无变化 | **ac487** | 342816 | ac487 | **ac487** |
| ------- | ------------------------------------------------------------------------------------------------------------------------------------- | --- | --------- | ------ | ----- | --------- |

| 第 3 个情况 | <p><strong>商品详情页2</strong></p><p>商品页内容中的值 342815 ，但是因为时间的缘故，没有发出来这个值</p><p>[www.s.com/pro?id=342815\&city=bj](http://www.s.com/pro?id=342815\&city=bj)</p> | 补了值 | NA | **342815** | NA | **342815** |
| ------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------- | --- | -- | ---------- | -- | ---------- |

| 第 4 个情况 | <p><strong>商品订单页1</strong></p><p>订单页没有打点，所以这里没有打点的值</p><p>[www.s.com/orderform?id=53462\&city=bj](http://www.s.com/orderform?id=53462\&city=bj)</p> | 补了值 | NA | NA | <p><strong>53462</strong></p><p>⚠️：本来用户没有打点，拿不到数据，现在有了订单编号业务意义的数据。这个业务意义与前面的商品编号不同。</p> | **53462** |
| ------- | --------------------------------------------------------------------------------------------------------------------------------------------------- | --- | -- | -- | --------------------------------------------------------------------------------------- | --------- |

* 取到的查询条件是b=时，则传 N/A，与现在一致；
* 查询条件里有 b=1\&b=2 ，取 b 的值为 2 ；
* URL 中存在 ?a=1#?b=2 ，第一个?是查询条件，即查询条件为a=1，第一个#是hash，即hash（路径中的一部分）为?b=2；
* 解析移动端的数据；
  {% endtab %}
  {% endtabs %}

{% hint style="success" %}
查看最近更新

单击圈选页面右上角的最近更新，查看刚刚定义的元素。
{% endhint %}

## 定义页面案例 <a href="#id-3-qi-ta-te-shu-qing-kuang" id="id-3-qi-ta-te-shu-qing-kuang"></a>

### **基础步骤 | 监控首页和全站的流量情况**

#### **1.定义首页：**

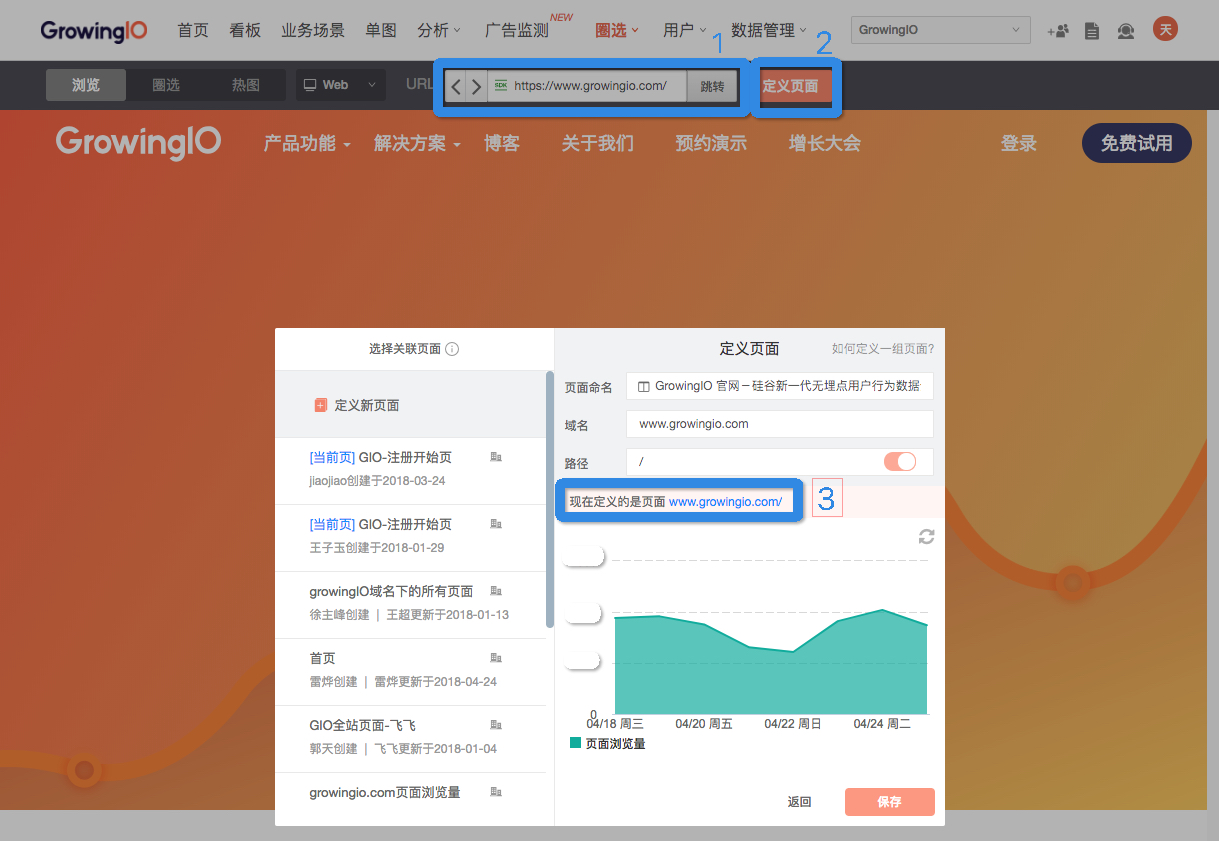
对于每个公司来说，首页都是比较重要的页面，通常会分析首页的流量从哪里来，以及首页的转化能力。首先，我要定义 GrowingIO 的首页。

第一步：在「圈选导航栏」中输入 url ，回车或点击跳转；

第二步：点击「定义页面」；

第三步：确认现在定义的页面 url 是否正确，修改「页面的名称」，保存。

![](https://docs.growingio.com/.gitbook/assets/20_40_02__04_25_2018.jpg)

定义完页面后，可以去「事件分析」中选择这个指标，就可以看到这个页面的基本数据情况了。

可以在「表格」中使用「访问来源」的维度来查看这个页面的流量都是从哪里来，也可以在案例2中学习到转化率的分析。

#### **2.定义全站页面组：**

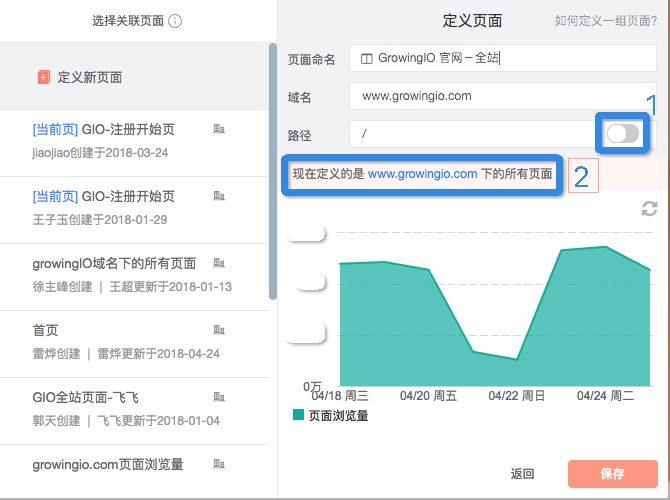
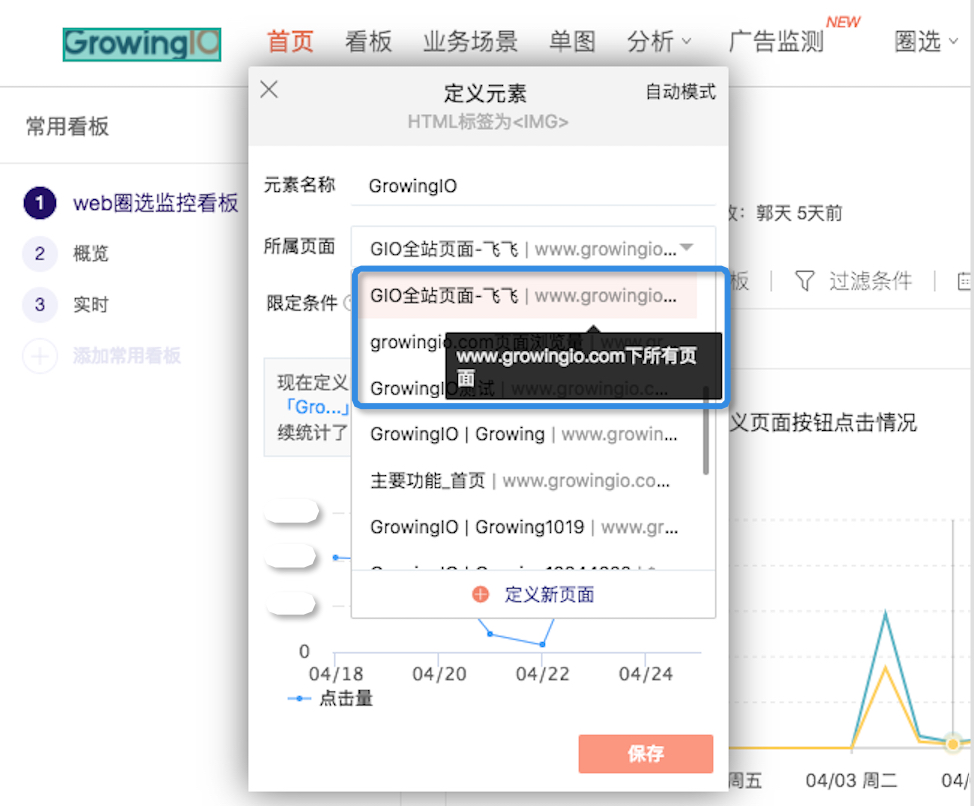
如果你想看到全站的总体流量情况，可以定义全站页面组。

在上面的第二步，点击「页面定义」后：

第一步：关闭「路径」开关；

第二步：确认现在定义的页面是否是域名下的所有页面；

![](https://docs.growingio.com/.gitbook/assets/21_04_22__04_25_2018.jpg)

### **案例一：注册转化率分析（定义每一个转化节点）**

注册流是很常见的转化流程了，注册数往往关乎核心的业务指标，因此，通常我们会有这样的分析需求。

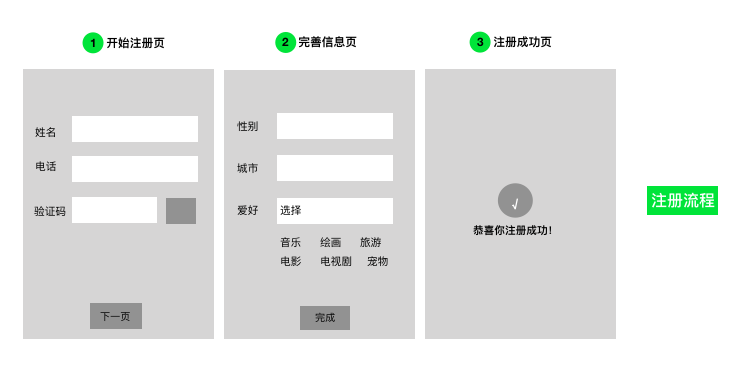
首先，我们需要清楚自己的注册流程是什么样的，比如是否分页，每一个按钮点击后是否一定会触达跳转，在这个转化流程中的关键节点有哪些。

接下来，我们来看一个注册流程：

![](https://docs.growingio.com/.gitbook/assets/image003.png)

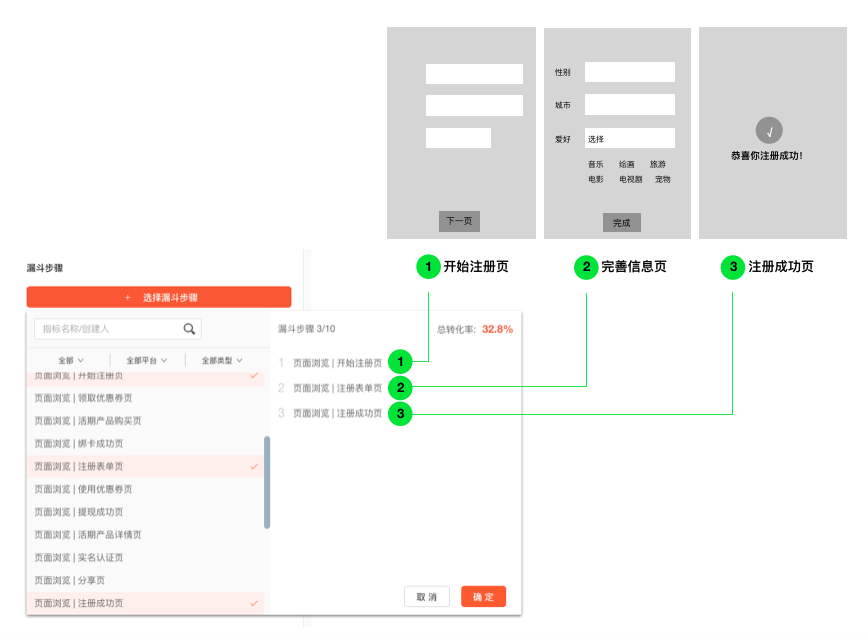
这是一个分页的注册流程，用户填写完上一页的内容才能进入到下一页，因此我可以将这三个页面作为漏斗的三个步骤，按照案例1的方式定义每一个页面。

然后，在漏斗分析中进行分析：

![](https://docs.growingio.com/.gitbook/assets/image005.png)

### **案例二：一组页面的分析（定义一组有相关业务意义的页面）**

很多网站的页面都是有规律的，层级结构清晰：

GrowingIO 解决方案首页 `https://www.growingio.com/solution/​`

GrowingIO 在线旅游解决方案落地页 `https://www.growingio.com/solution/online-travel`

GrowingIO 互联网金融解决方案落地页 `https://www.growingio.com​/solution/internet-finance`

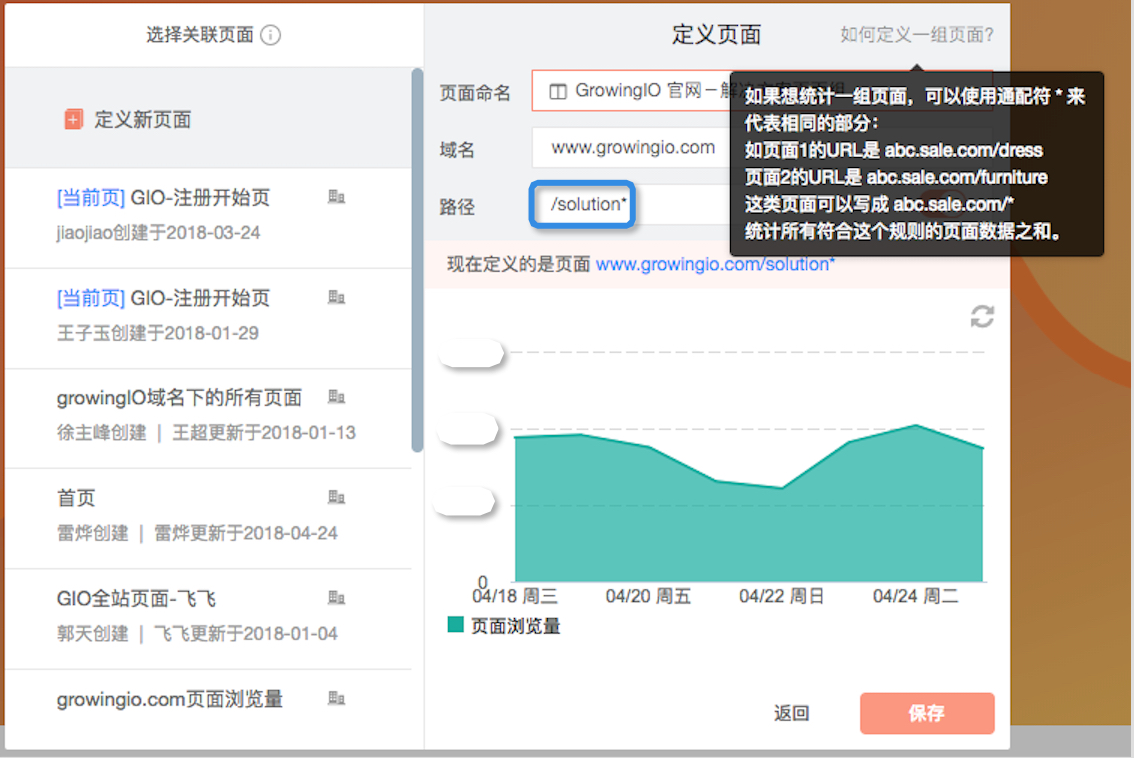
我们发现所有的解决方案落地页都是 `https://www.growingio.com/solution/xxx` ，那么如果我想统计所有解决方案页的页面情况，就可以通过通配符「\*」来定义一组页面 `https://www.growingio.com/solution/*`，即：​

![](https://docs.growingio.com/.gitbook/assets/20_59_35__04_25_2018.jpg)

### **案例三：特殊页面定义——页面 url 中带有 「?」**

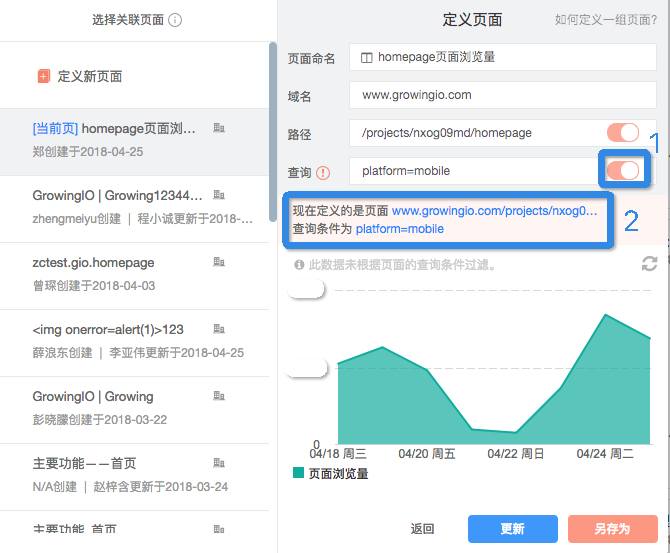
如果你发现你的页面 url 中带有「?」，除了用于监测广告投放的 utm 之外，需要在定义页面时手动打开「查询条件」的开关，这种情况是不支持回溯数据的，将从你定义页面的时候开始统计数据：

![](https://docs.growingio.com/.gitbook/assets/21_17_01__04_25_2018.jpg)

## **定义元素案例**

### **基本步骤 | 监控重要的按钮数据（定义元素）**

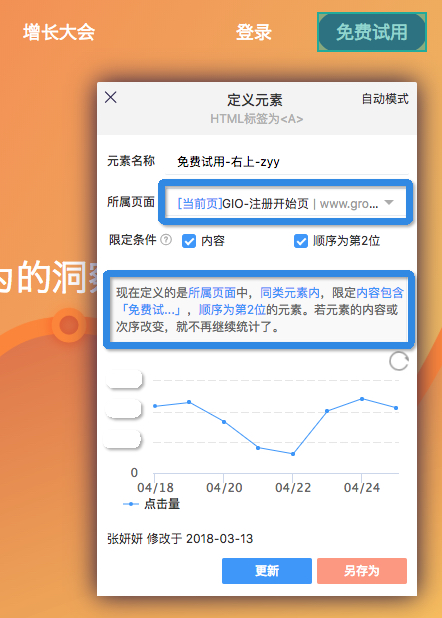
注册按钮在首页的点击量是一个重要的数据，因此，我们需要定义这个元素。

首先，在「圈选」模式下点击这个按钮：

第一步：确认元素所在页面是否正确，默认的是「当前页面」；

第二步：根据下图中第二个蓝色框中的文字，确认统计规则是否符合需求；

第三步：填写一个容易理解的名称，然后就可以保存了。

![](https://docs.growingio.com/.gitbook/assets/21_20_14__04_25_2018.jpg)

接下来，可以在「事件分析」等分析工具中使用。

### **案例一：分析一个商品位、测试按钮等（定义一个位置）**

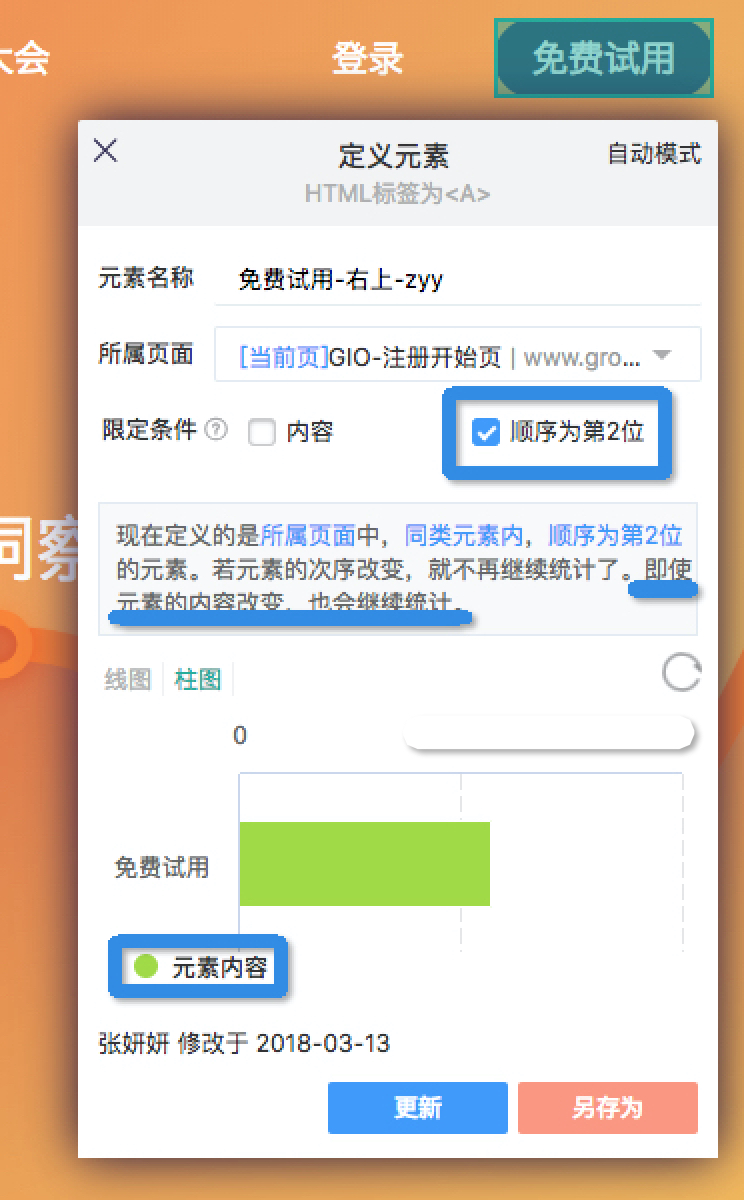
我们在圈选时只能看到一种元素，但是可能用户看到的网站内容不一样，元素的内容也不一样，因此，当我们在定义一个元素时，要思考我们想要统计的是「现在这个位置的按钮点击情况」还是「这个位置上这个内容的按钮的点击情况」。常见于商品位、AB测试等使用场景。

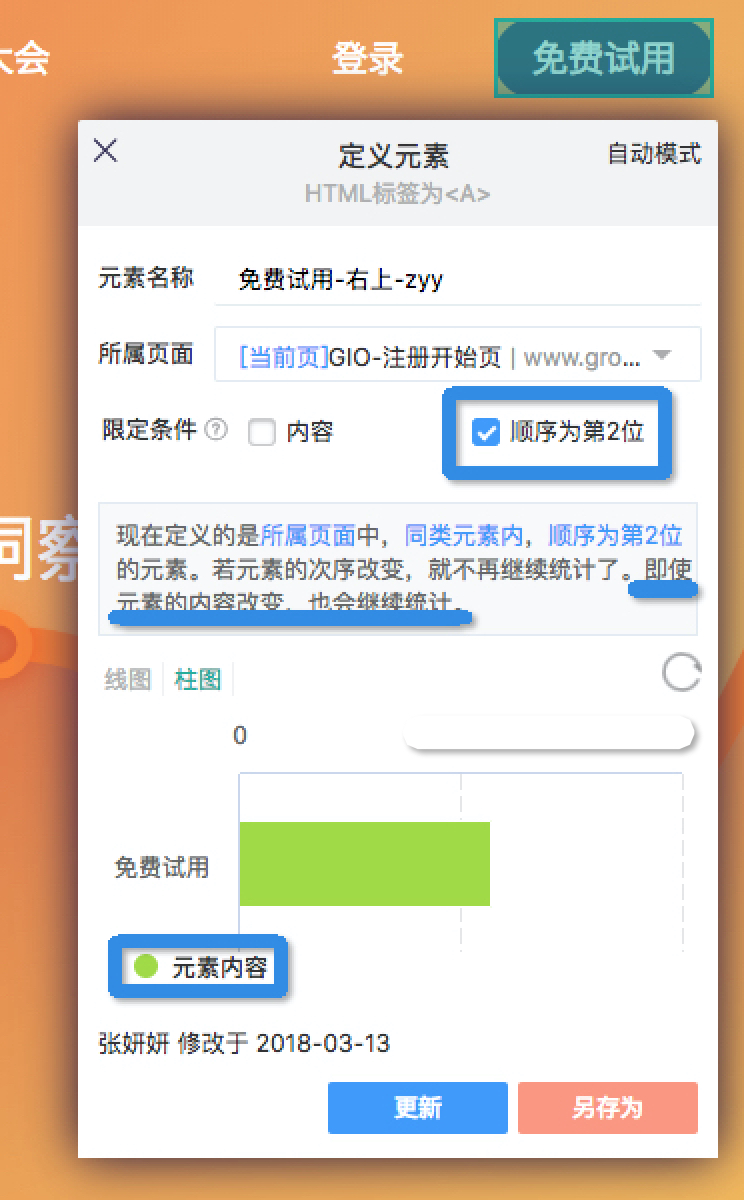
在下图中，有一部分用户看到的按钮是「立即注册」，还有一部分用户看到的按钮是「免费试用」，因此，如果我想定义这个按钮的点击情况，不管是什么内容，那么就只「限定顺序」，不限定其他条件：​

![](https://docs.growingio.com/.gitbook/assets/21_32_36__04_25_2018%20%281%29.jpg)

如果想看这个位置上不同内容的点击情况，可以在「事件分析」中，选择「柱图」，用「元素内容」作为维度，来进行分析。

### **案例二：导航栏分析（定义一个跨页面的元素）**

如果想要分析导航栏的点击情况，我们就会发现这是一类特殊的元素，因为他们出现在网站的多个页面中。

因此，在定义这类元素时，要注意选择全站页面组，如果没有定义全站页面组，需要先去「定义页面」，详见「定义页面部分」的「基本步骤」。

![](https://docs.growingio.com/.gitbook/assets/21_29_04__04_25_2018.jpg)

### **案例三：比较一些长得差不多的元素（定义一组元素）**

当我们想要定义一组列表，或者一组元素时，会发现他们通常结构很像，圈选提供了一种便捷的方式，通过定义「同类元素」的方式来定义一组元素。选中这样的元素后，依然是先确认它的所属页面是否正确，然后「不限定任何限定条件」，这时可以注意第二个蓝框中的话：现在定义的是所属页面中，所有同类元素的数据之和。我们已经将这组同类元素用虚线框标记出来。这时，你就成功定义了这个元素所在的列表。

![](https://docs.growingio.com/.gitbook/assets/21_32_36__04_25_2018.jpg)

然后在「事件分析」中使用「元素内容」的维度进行分析。